Japanese
English
特集 予測と意思決定の神経科学
中脳における報酬予測誤差計算機構
Computation of reward prediction error in the midbrain circuit
小林 康
1,2,3
,
岡田 研一
1,2
Yasushi Kobayashi
1,2,3
,
Ken-ichi Okada
1,2
1大阪大学大学院 生命機能研究科
2NICT脳情報通信融合研究センター
3大阪大学 社会経済研究所
pp.319-322
発行日 2013年8月15日
Published Date 2013/8/15
DOI https://doi.org/10.11477/mf.2425101462
- 有料閲覧
PPV購入案内
1,320円 (1,200円+税10%) こちらは、319ページから322ページの文献です。
PPV(ペイ・パー・ビュー)とは、論文(記事)単位で購入・閲覧ができるサービスです。
購入には医書.jp本会員登録が必要です。
会員登録完了後に改めて上記「購入サイトへ」を選択してください。
または「購入サイトへ」選択後に「購入ログイン」、「新規会員登録」の順に進んでください。
会員登録について詳しくはをご確認ください。
購入には医書.jp本会員登録が必要です。
会員登録完了後に改めて上記「購入サイトへ」を選択してください。
または「購入サイトへ」選択後に「購入ログイン」、「新規会員登録」の順に進んでください。
会員登録について詳しくはをご確認ください。
- Abstract 文献概要
- 1ページ目 Look Inside
- 参考文献 Reference
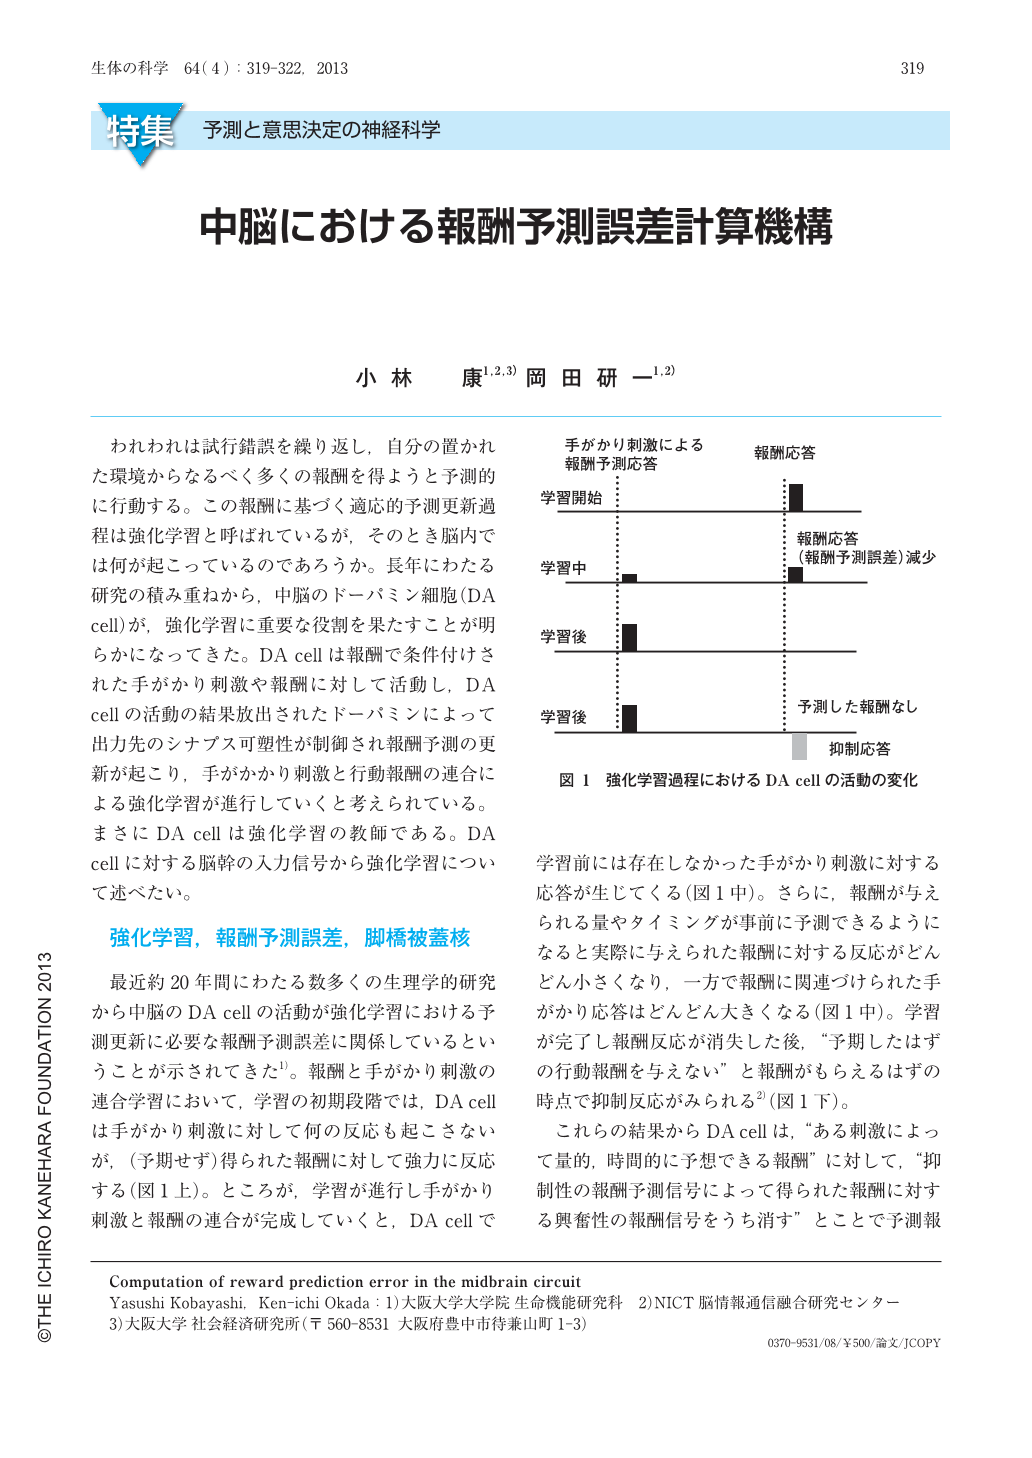
われわれは試行錯誤を繰り返し,自分の置かれた環境からなるべく多くの報酬を得ようと予測的に行動する。この報酬に基づく適応的予測更新過程は強化学習と呼ばれているが,そのとき脳内では何が起こっているのであろうか。長年にわたる研究の積み重ねから,中脳のドーパミン細胞(DA cell)が,強化学習に重要な役割を果たすことが明らかになってきた。DA cellは報酬で条件付けされた手がかり刺激や報酬に対して活動し,DA cellの活動の結果放出されたドーパミンによって出力先のシナプス可塑性が制御され報酬予測の更新が起こり,手がかかり刺激と行動報酬の連合による強化学習が進行していくと考えられている。まさにDA cellは強化学習の教師である。DA cellに対する脳幹の入力信号から強化学習について述べたい。
Copyright © 2013, THE ICHIRO KANEHARA FOUNDATION. All rights reserved.